
Jak przygotować stronę pod AI Search
Obraz wygenerowany przez AI (Midjourney)
Coraz więcej ludzi nie wpisuje już frazy w Google - pyta ChatGPT, Perplexity albo czyta AI Overviews na górze wyników. To już nie jest marginalny ruch: w 2026 roku około 68% wyszukiwań w Google w USA kończy się bez żadnego kliknięcia w wynik, a kiedy pojawia się podsumowanie AI Overviews, ten odsetek skacze do 83%[1]. Twoja strona może być dla Google idealnie zoptymalizowana i jednocześnie kompletnie niewidoczna dla tych narzędzi. Widoczność w zwykłych wynikach nie daje pewności, że strona pojawi się również w odpowiedzi AI.
Przez ostatnie tygodnie sprawdzałem siedem swoich serwisów pod kątem widoczności w wyszukiwaniu opartym na AI. Oto dokładnie, co zrobiłem, dlaczego i na jakich danych się opieram - nie na przeczuciach.
Czym różni się AI Search od SEO
W klasycznym SEO zależy nam na wysokiej pozycji strony w wynikach wyszukiwania. W przypadku AI Search chodzi również o to, by narzędzie wykorzystało Twoją stronę jako źródło odpowiedzi. Działania służące tej widoczności określa się jako GEO, czyli Generative Engine Optimization. Użytkownik dostaje odpowiedź wraz z odsyłaczami do wybranych źródeł. Warto sprawdzać zarówno cytowania, jak i wejścia na stronę.
Nazwa "GEO" nie jest marketingowym wymysłem - to pojęcie opisane w pracy naukowej, zaprezentowanej na konferencji ACM SIGKDD 2024 przez badaczy z Princeton, Georgia Tech, Allen Institute for AI i IIT Delhi[2]. Zespół przetestował strategie optymalizacji na około 10 000 zapytań i sprawdził, co faktycznie zwiększa widoczność w odpowiedziach generowanych przez AI. Jeden wniosek szczególnie warto zapamiętać: dodanie statystyk, cytatów i odniesień do źródeł podniosło widoczność treści nawet o 40 procent.
Innymi słowy: to, że ten artykuł jest pełen liczb i linków do źródeł, to nie ozdobnik. To dokładnie ta sama technika, o której właśnie piszę.
Wpuść boty AI - dosłownie
Zacząłem od sprawdzenia pliku robots.txt. Błędne lub zbyt szerokie reguły mogą utrudnić wybranym robotom pobieranie treści. To nie jest rzadki przypadek: ClaudeBota blokuje dziś 69% stron, a GPTBota 62%[3]. Sama blokada nie wyjaśnia jednak, czy właściciel strony wprowadził ją świadomie, czy przejął gotowe ustawienia.
Warto rozróżnić funkcje poszczególnych robotów:
- OpenAI:
GPTBot(trenowanie modeli),OAI-SearchBot(indeksowanie na potrzeby wyszukiwania),ChatGPT-User(pobranie strony na bezpośrednie żądanie użytkownika w trakcie rozmowy) - regułyrobots.txtmogą nie dotyczyćChatGPT-Usertak samo ściśle jak pozostałych dwóch[4]. - Anthropic:
ClaudeBot(trenowanie),Claude-SearchBot(indeksowanie),Claude-User(żądanie użytkownika) - to jedyny z dużych graczy, który deklaruje, że wszystkie trzy boty honorująrobots.txtbez wyjątku, łącznie z tym trzecim[4]. - Google:
Google-Extended- inny token niż zwykły Googlebot, kontroluje wyłącznie wykorzystanie treści do trenowania AI, nie klasyczne indeksowanie. - Perplexity:
PerplexityBotiPerplexity-User- podobnie jak w OpenAI, reguły dla bota działającego na żądanie użytkownika generalnie nie obowiązują tak samo jak dla crawlera indeksującego[4]. - Apple:
Applebot-Extended.
Microsoft Copilot nie ma własnego bota - korzysta z indeksu Bingbota, więc jeśli wpuszczasz Binga, wpuszczasz i Copilota.
llms.txt - ściąga dla modeli językowych
To proponowana konwencja opisana na llmstxt.org[5]: plik w formacie Markdown w głównym katalogu strony (albo w podkatalogu, jeśli dotyczy tylko jego części), który w kilku zdaniach i liście linków tłumaczy modelowi, czym strona jest i co na niej najważniejsze. Można go potraktować jako zwięzły przewodnik po stronie. Nie zastępuje mapy witryny ani zasad dostępu zapisanych w robots.txt. Nazywa się go czasem "robots.txt dla AI", choć robi coś dokładnie odwrotnego: nie ogranicza dostępu, tylko ułatwia zrozumienie.
Traktuję llms.txt jako dodatkowy przewodnik, nie warunek widoczności. Google wskazuje, że w AI Overviews i AI Mode obowiązują podstawowe zasady SEO. Nie wymaga specjalnych plików dla AI ani dodatkowych oznaczeń i nie gwarantuje wyświetlenia strony nawet po spełnieniu wszystkich wymagań.[7]
Dane strukturalne - mów wprost, nie każ się domyślać
Schema.org (JSON-LD w kodzie strony) to sposób, żeby powiedzieć wprost: to jest firma, to jest osoba, to jest artykuł, to jest definicja pojęcia. Takie oznaczenia pomagają systemom rozpoznać rodzaj treści. Powinny odpowiadać temu, co czytelnik rzeczywiście widzi na stronie.
Zbudowałem w ten sposób nawet słownik pojęć na tej stronie - każde hasło to osobny DefinedTerm, więc kiedy ktoś zapyta AI "co to jest canonical URL", może trafić na tę definicję. Samo oznaczenie DefinedTerm nie gwarantuje jednak cytowania.
To nie kończy się na kodzie
Robots.txt, llms.txt i dane strukturalne otwierają drzwi, ale samo to nikogo jeszcze nie przekonuje, że warto przez nie wejść. Model AI, zapytany o dobrego dostawcę czegokolwiek, nie cytuje przypadkowej strony - cytuje źródło, które gdzieś już rozpoznał jako wiarygodne.
Google nazywa to od lat E-E-A-T: Experience, Expertise, Authoritativeness, Trust - realne doświadczenie, wiedza, uznanie w branży i zaufanie, opisane wprost w oficjalnych Search Quality Rater Guidelines[6]. Sam dokument stwierdza wprost, że zaufanie jest najważniejszym elementem całej czwórki - strona bez zaufania ma niskie E-E-A-T bez względu na to, jak bardzo wygląda na doświadczoną czy ekspercką. To nie jest algorytm w wąskim sensie - to zbiór kryteriów, według których ludzie oceniają jakość wyników, a te oceny pomagają Google sprawdzać jakość działania wyszukiwarki. W swojej pracy traktuję to jako wskazówkę: opisuję doświadczenie autora, podaję źródła i dbam o rzetelność informacji.
A "wiarygodne gdzie indziej" oznacza dosłownie: w innych miejscach niż Twoja własna strona. Wzmianka w mediach, artykuł ekspercki, cytat w cudzym tekście - to sygnały autorytetu, których nie da się wpisać do pliku konfiguracyjnego. Wzmianki i odsyłacze mogą pomóc odbiorcy sprawdzić, czym zajmuje się autor lub firma. Dlatego łączę pracę nad stroną, treściami i obecnością w mediach. Strona idealnie oznaczona danymi strukturalnymi, ale bez treści wartej zacytowania, nie stanie się przez to wartościowym źródłem. Świetny artykuł prasowy, który nie prowadzi z powrotem do strony gotowej go przyjąć, nie ułatwi czytelnikowi znalezienia dalszych informacji.
Treść, którą chce się cytować
Sprawdzenie ustawień to początek. Równie ważna jest sama treść: konkretne, jednoznaczne zdania są bardziej użyteczne niż marketingowe ogólniki. W opisanym wcześniej badaniu GEO dodanie cytatów, statystyk i źródeł poprawiło widoczność treści w badanych odpowiedziach. Nie oznacza to, że każdy podobny zabieg da taki sam wynik na dowolnej stronie. Krótka definicja w jednym zdaniu cytuje się łatwiej niż akapit lania wody.
Dlatego dodaję sekcje FAQ z pytaniami, które rzeczywiście zadają klienci, i krótkimi odpowiedziami. Ważna jest też możliwość sprawdzenia autora i jego doświadczenia poza własną stroną. Żaden z tych elementów nie daje jednak gwarancji cytowania.
To nie jest jednorazowa akcja
AI Search zmienia się szybciej niż klasyczne SEO - nowe boty, nowe konwencje, nowe zasady co kilka miesięcy. Sam ruch crawlerów pokazuje tempo tej zmiany: odsetek stron odwiedzanych przez robota wyszukiwania OpenAI wzrósł w ciągu ostatniego roku z 4,7% do ponad 55% stron, podczas gdy blokowanie ich robota zbierającego dane do trenowania modeli spadło z 84% do 12%[3] - strony coraz wyraźniej rozróżniają "wpuszczam AI, żeby mnie znajdowało" od "nie chcę, żeby trenowało się na moich treściach". Traktuję to jak stały element utrzymania strony, nie jak coś, co robi się raz i zapomina.
Jak sprawdzić, czy Copilot Cię cytuje
Cytowania można sprawdzać m.in. w bezpłatnym panelu Bing Webmaster Tools. Panel AI Performance pokazuje cytowania z Microsoft Copilot i partnerów - ile razy strona pojawiła się w odpowiedzi i ile jej podstron zostało zacytowanych, w rozbiciu na dni. Konfiguracja zajmuje kilka minut, bo Bing Webmaster Tools pozwala zaimportować witrynę wprost z Google Search Console, więc nie trzeba drugi raz przechodzić przez weryfikację.
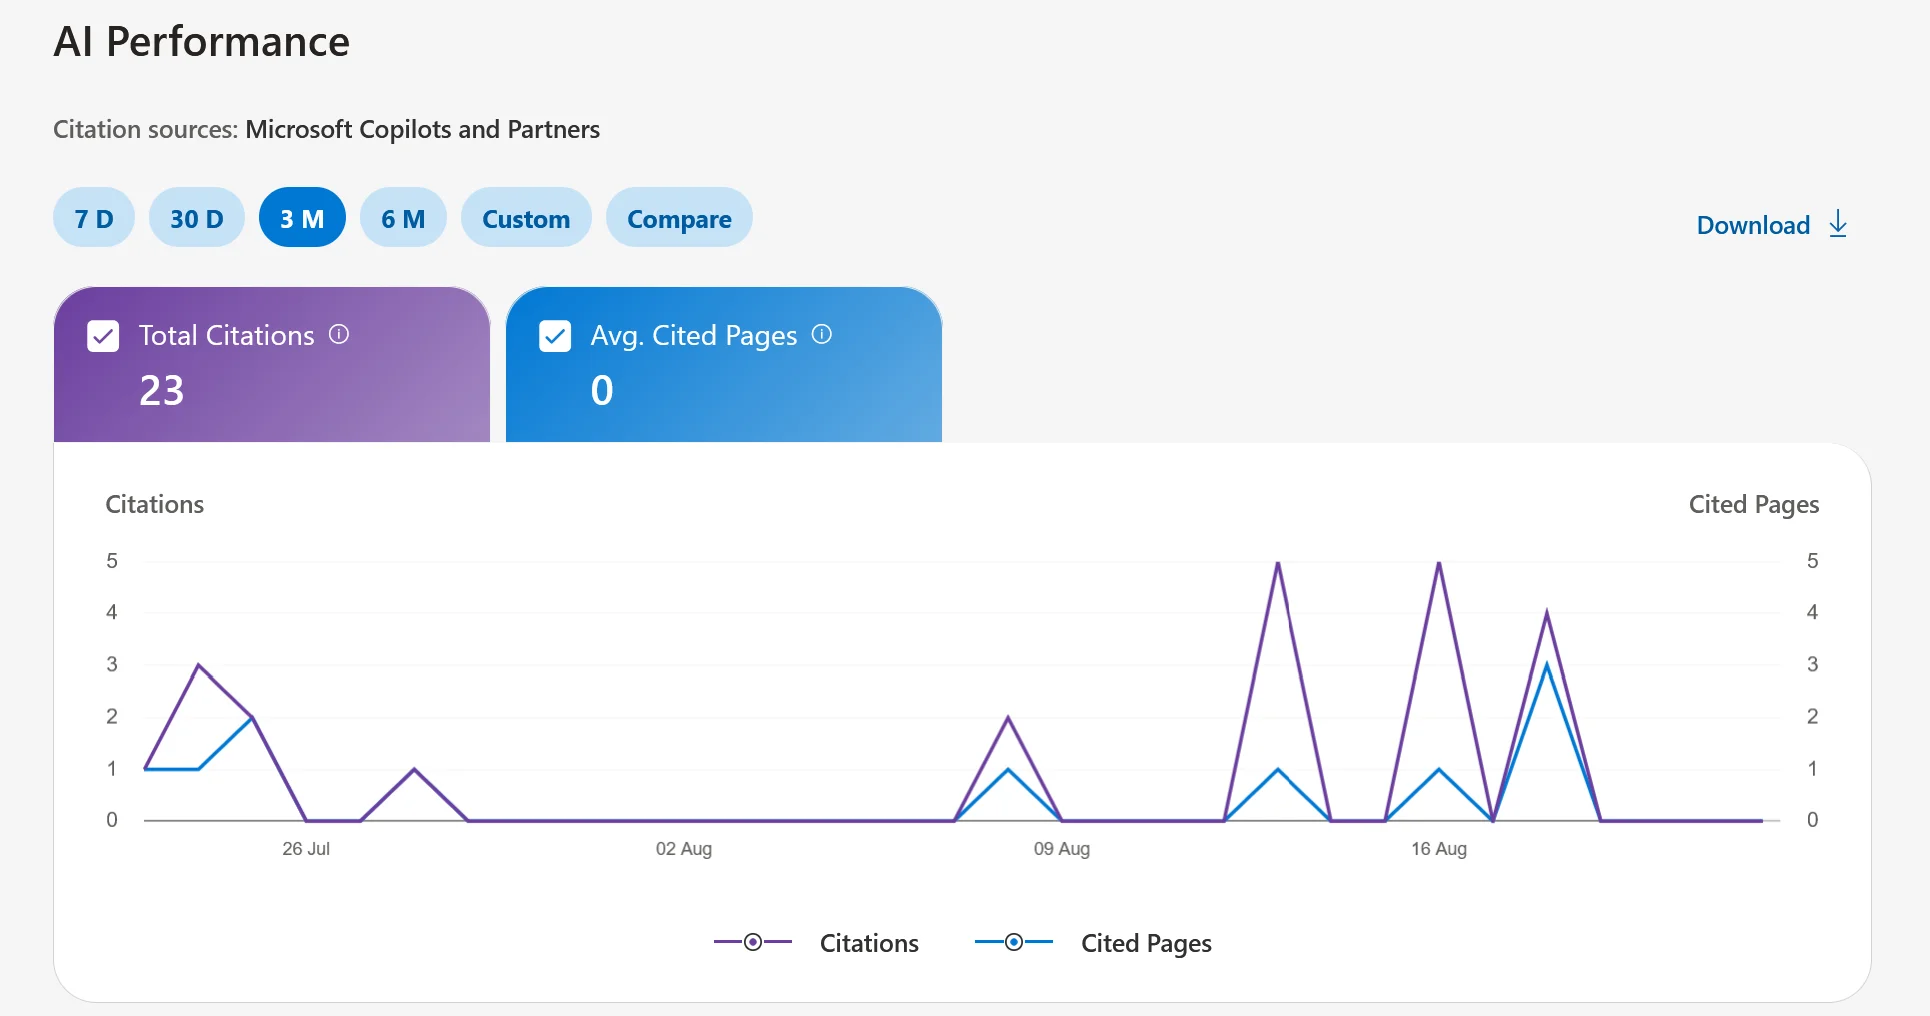
Panel AI Performance w Bing Webmaster Tools - widok cytowań i zacytowanych podstron w ujęciu trzymiesięcznym.
To narzędzie ma wyraźną granicę: pokazuje cytowania z ekosystemu Microsoftu, czyli Copilota i partnerów, nie ChatGPT, Perplexity czy Google AI Overviews. Mimo to warto tam zaglądać - pozwala zobaczyć konkretne dane o cytowaniach zamiast opierać się na domysłach.
Jeśli Twoja strona nigdy nie była pod tym kątem sprawdzona - albo jeśli masz stronę, treść i PR rozrzucone między kilku dostawców, którzy w ogóle ze sobą nie rozmawiają - napisz. Zrobię audyt i powiem konkretnie, czego brakuje i gdzie się to wszystko rozjeżdża.
Źródła
- Search Engine Land, "Google zero-click searches reach 68% in early 2026"
- Aggarwal, Murahari, Rajpurohit, Kalyan, Narasimhan, Deshpande, "GEO: Generative Engine Optimization", ACM SIGKDD 2024
- No Hacks, "The AI User-Agent Landscape in 2026"
- ALM Corp, "Anthropic's Three-Bot Framework and What It Means for Your robots.txt Strategy"
- llmstxt.org - oficjalna specyfikacja llms.txt
- Google, Search Quality Rater Guidelines
- Google Search Central, AI features and your website — wymagania, podstawowe zasady SEO i brak gwarancji wyświetlenia.